Contexte, sémantique, ontologie : les trois notions à maîtriser avant de confier l’activation CRM à des agents IA.
De plus en plus de marques veulent confier l’activation CRM à des agents IA : à partir des signaux clients, ils choisissent le message, l’offre et le moment.
La promesse est réelle. On passe d’un marketing par segments et calendrier de campagnes à un marketing qui réagit à chaque signal : une fin de séjour, une réclamation, un changement de comportement.
Le risque l’est tout autant : se tromper plus vite, faute de contexte et d’une vision complète du client.
Dans cet article : un exemple concret de ce qui manque aux agents, des enseignements, les notions à comprendre (contexte, sémantique, ontologie) et les principes terrain pour démarrer.
1. L’exemple : l’agent qui remercie pour un séjour raté
Prenons un exemple fictif dans l’hôtellerie. Un membre Platine du programme de fidélité, client depuis vingt ans, rentre d’un séjour à Paris en octobre. L’agent IA qui pilote son parcours lui écrit « Un magnifique séjour dans la Ville Lumière » et lui propose de réserver à nouveau.
Problème : le client a très mal dormi et a changé plusieurs fois de chambre. L’incident est noté dans le PMS de l’hôtel (son logiciel de gestion), pas dans les données de l’agent. Quant aux perturbations qui touchaient Paris ce mois-là, l’agent pourrait les trouver en ligne, mais rien ne les relie à ce séjour.
L’agent a suivi son objectif. Il lui manquait le contexte.
Avec ce contexte, la lecture change complètement. Ce n’est pas un simple incident : c’est un client à forte valeur exposé à un risque de départ, et sans doute pas le seul ce mois-là. La bonne réponse n’est pas une nouvelle offre, mais des excuses et un geste à la hauteur de sa fidélité. L’offre commerciale attendra.
Pourquoi un agent plutôt qu’un scénario automatisé ? Un scénario peut gérer ce cas précis, à condition que quelqu’un l’ait prévu. Mais la bonne décision dépend de la combinaison de plusieurs informations (statut, historique, incident, situation externe), et ces combinaisons se multiplient plus vite qu’on ne peut écrire de scénarios. C’est là que l’agent apporte de la valeur, à condition de disposer du contexte.
2. Trois enseignements
1/ Un agent ne voit du client que ce que ses données lui montrent
Si le parcours client est dispersé en silos (CRM, réservation, fidélité, service client, outils des hôtels), l’agent n’en perçoit que des morceaux. Dans notre exemple, l’information décisive existait : elle n’était simplement pas accessible à l’agent.
Relier les sources autour d’un client unifié est la première condition. Pas la dernière.
2/ Une donnée isolée ne dit pas quoi faire
Un changement de chambre, pris seul, reste une ligne dans une table. Rattaché au séjour, à l’historique de fidélité, à la valeur du client et à l’actualité, il devient une information utile à la décision.
C’est tout l’enjeu de la sémantique et de l’ontologie : donner un sens partagé aux données et expliciter les relations qui les unissent.
3/ Un tuyau ne remplace pas une règle
Brancher le PMS à l’agent, via MCP par exemple, lui donnerait accès à l’incident. Sans règle explicite (un incident appelle un geste avant toute offre), il l’aurait vu… et proposé quand même un nouveau séjour.
Et quel geste ? Points de fidélité, surclassement, avoir : qui le finance, l’hôtel ou le programme, et jusqu’à quel montant ? Ces arbitrages relèvent du métier, pas du modèle. Ils doivent être écrits, validés et accessibles à l’agent.
3. Contexte, sémantique, ontologie : de quoi parle-t-on ?
Ces trois termes circulent beaucoup depuis l’essor des agents, souvent l’un pour l’autre. Voici les définitions que nous retenons, alignées sur celles du marché.
Le contexte : éclairer chaque décision
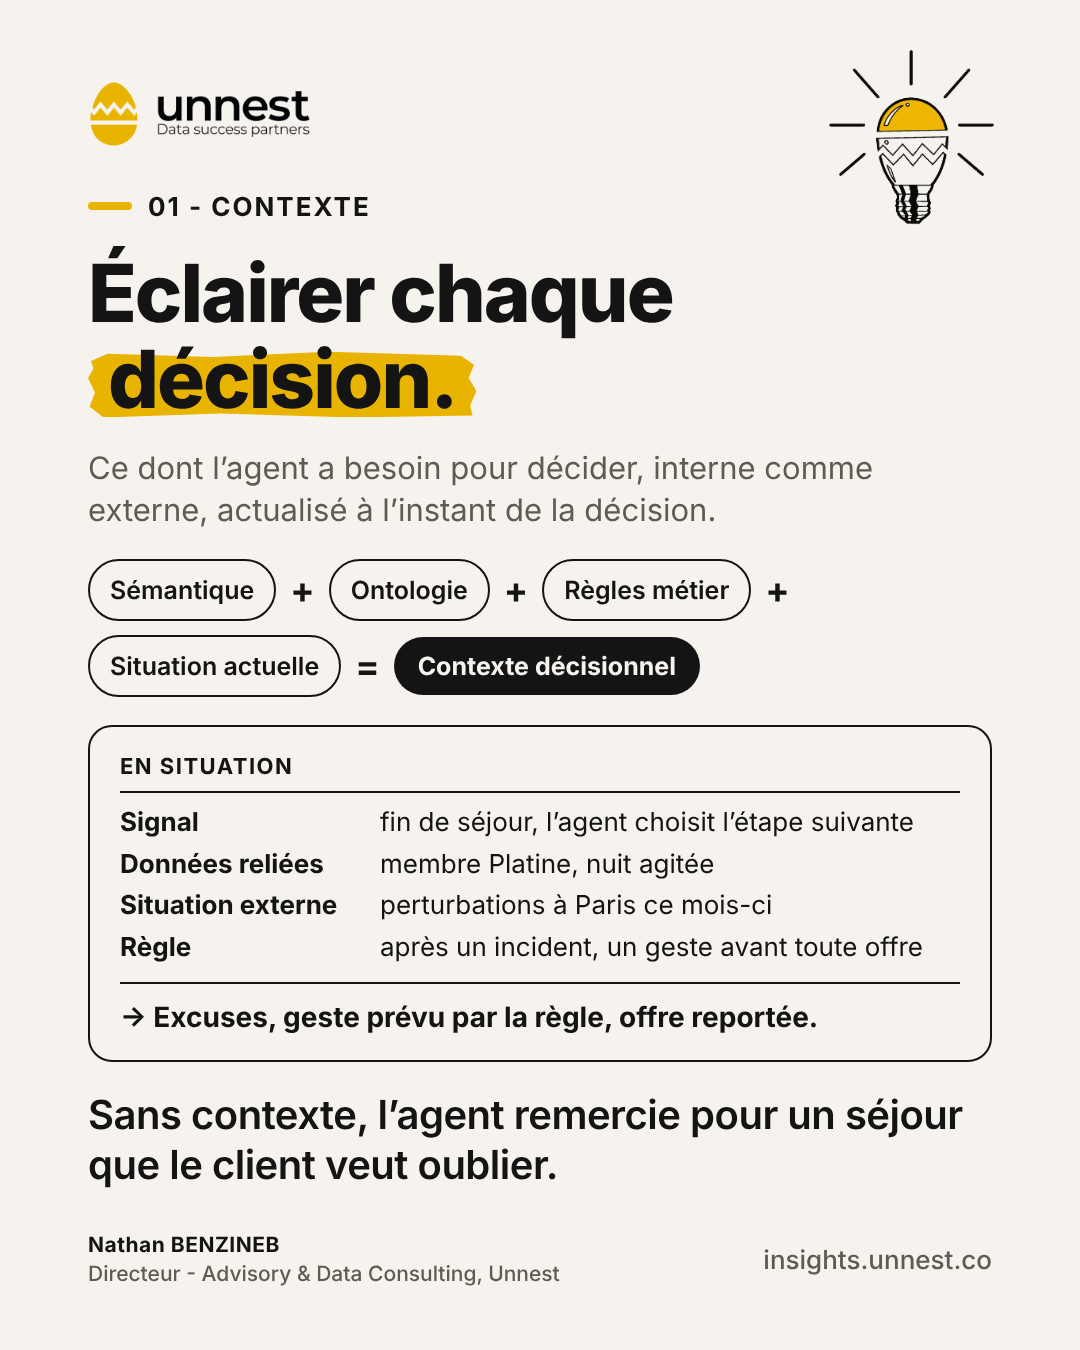
Le contexte décisionnel, c’est ce dont l’agent a besoin pour décider, interne comme externe, actualisé à l’instant de la décision. Il combine quatre briques :
- La sémantique : ce que veulent dire les données.
- L’ontologie : comment les concepts métier sont reliés entre eux.
- Les règles métier : ce qui est prioritaire, autorisé ou exclu.
- La situation actuelle : ce qui se passe maintenant, chez le client et autour de lui.
Appliqué à notre exemple : le signal (fin de séjour) déclenche la décision. Les données reliées (membre Platine, nuit agitée) et la situation externe (perturbations à Paris) l’éclairent. La règle (un geste avant toute offre) la cadre. Résultat : excuses, geste prévu par la règle, offre reportée.
Gartner recommande d’ailleurs aux responsables data & analytics de faire du « context layer » une brique centrale de leur infrastructure.
La sémantique : partager le sens
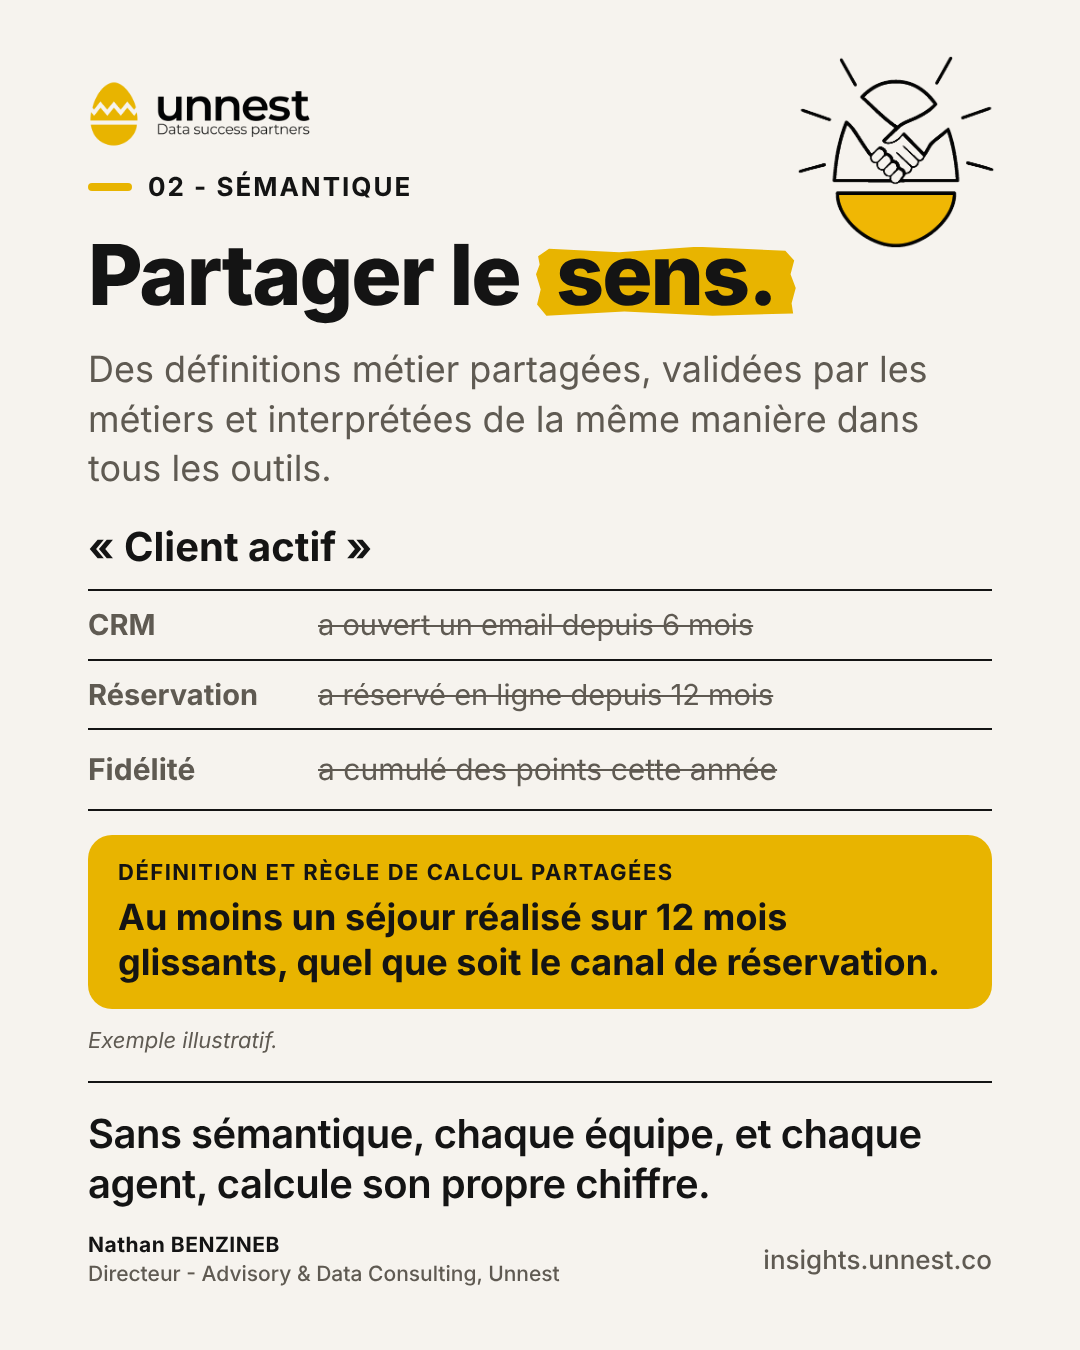
Une couche sémantique rassemble des définitions métier partagées, validées par les métiers, avec une seule règle de calcul, interprétée de la même manière dans tous les outils : BI, CRM… et désormais agents.
Prenons « client actif ». Pour le CRM, c’est un client qui a ouvert un email depuis six mois. Pour l’équipe réservation, un client qui a réservé en ligne depuis douze mois. Pour la fidélité, un membre qui a cumulé des points cette année. Trois définitions, trois chiffres, et autant de débats en comité de pilotage.
Une définition partagée tranche : au moins un séjour réalisé sur douze mois glissants, quel que soit le canal de réservation (exemple illustratif).
Pour un agent, l’enjeu est encore plus fort qu’en BI. Interrogé sur les « clients actifs », il choisira une table, une définition, et répondra avec assurance. Sans couche sémantique, chaque équipe, et chaque agent, calcule son propre chiffre.
Ces définitions sont des décisions métier. Les équipes data peuvent les outiller, pas les arbitrer seules.
L’ontologie : encoder le métier
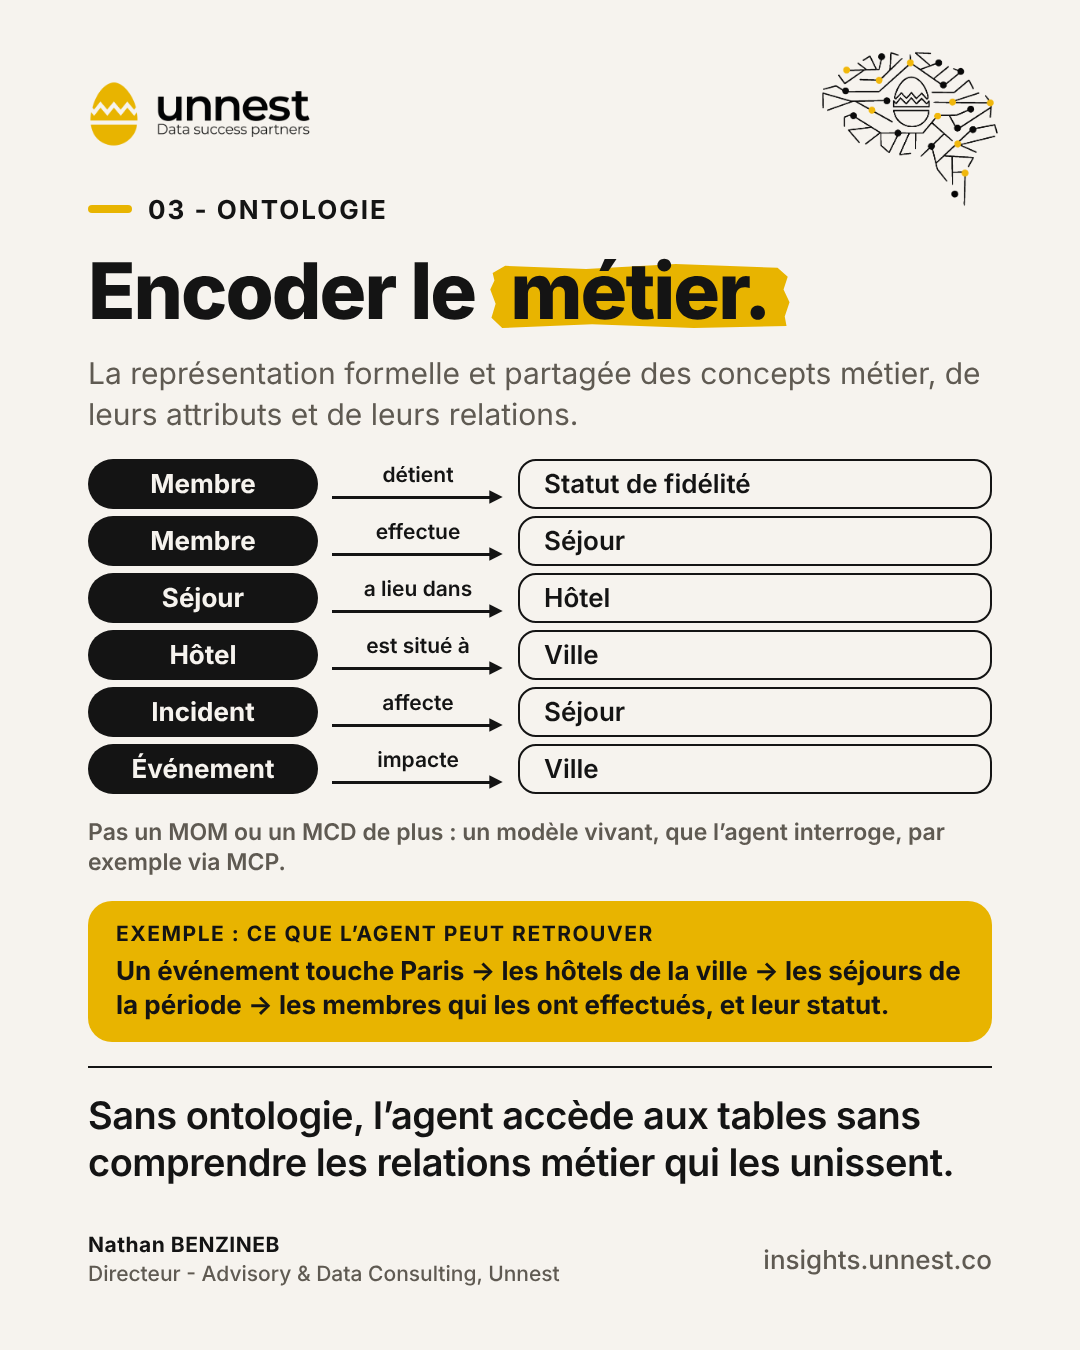
L’ontologie est la représentation formelle et partagée des concepts métier, de leurs attributs et de leurs relations. Dans notre exemple : un membre détient un statut de fidélité et effectue des séjours ; un séjour a lieu dans un hôtel ; un hôtel est situé dans une ville ; un incident affecte un séjour ; un événement impacte une ville.
Ces relations permettent à l’agent de raisonner. Un événement touche Paris : il retrouve les hôtels de la ville, les séjours de la période, les membres qui les ont effectués et leur statut. Sans ontologie, l’agent accède aux tables sans comprendre les relations métier qui les unissent.
« Ce n’est pas ce que fait déjà notre modèle de données ? » L’objection est légitime, et Gartner y répond sans détour : les modèles de données fondés sur des schémas, à eux seuls, ne donnent pas à l’IA agentique le contexte métier et le sens des données dont elle a besoin. La différence tient en quelques points :
Modèle de données (MCD, MOM) | Ontologie | |
Rôle | Structurer les données d’un système ou d’un domaine | Représenter le sens métier, de façon transverse aux systèmes |
Périmètre | Une application, un entrepôt | CRM, réservation, fidélité, données externes… |
Utilisateurs | Équipes techniques, requêtes SQL | Métiers, applications et agents, qui l’interrogent directement |
Raisonnement | Tables, clés et jointures | Relations typées et règles d’inférence |
Évolution | Suit les projets techniques | Évolue avec le métier, comme un référentiel vivant |
Un exemple d’inférence : si un incident affecte un séjour, et qu’un membre a effectué ce séjour, alors ce membre est concerné par l’incident. Dans l’ontologie, cette déduction est explicite. Dans un modèle de données, elle reste implicite, dans les requêtes de ceux qui savent.
En résumé
Notion | La question à laquelle elle répond | Dans notre exemple | Sans elle |
Contexte | Que faut-il savoir pour décider, maintenant ? | Membre Platine + nuit agitée + Paris perturbé + règle « un geste avant toute offre » | L’agent remercie pour un séjour que le client veut oublier |
Sémantique | Que veut dire cette donnée ? | « Client actif » = au moins un séjour sur 12 mois glissants | Chaque équipe, et chaque agent, calcule son propre chiffre |
Ontologie | Comment les concepts sont-ils reliés ? | Un incident affecte un séjour, effectué par un membre Platine | L’agent voit des tables, pas les relations métier |
4. Le chantier prioritaire de 2027
Le sujet n’est plus théorique, et les signaux convergent.
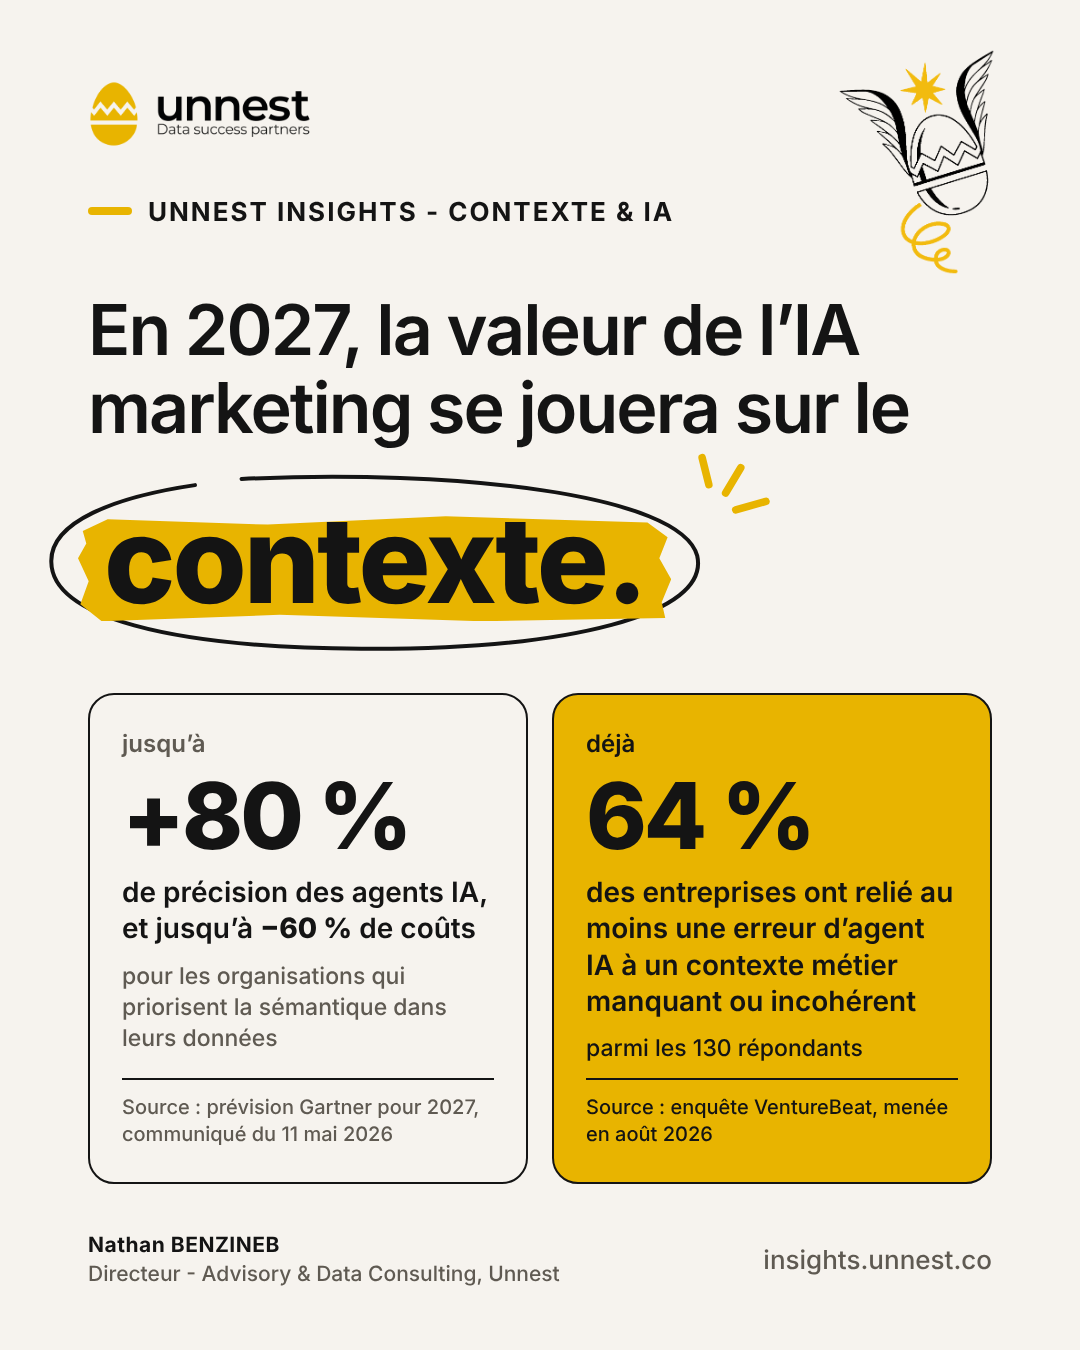
Le gain est chiffré. Gartner estime que d’ici 2027, les organisations qui priorisent la sémantique dans des données prêtes pour l’IA augmenteront la précision de leurs agents IA jusqu’à 80 % et réduiront leurs coûts jusqu’à 60 % (communiqué du 11 mai 2026). Rita Sallam, Distinguished VP Analyst chez Gartner, invite à budgéter ces capacités sémantiques comme un socle non négociable.
Le problème est déjà là. Dans une enquête VentureBeat menée en août 2026 auprès de 130 répondants, 64 % ont relié au moins une réponse fausse, mais assurée, d’un agent IA à un contexte métier manquant ou incohérent : définitions de métriques erronées, données périmées… Le panel est auto-sélectionné et composé surtout d’entreprises de taille intermédiaire : à lire comme un signal, pas comme une mesure du marché.
Les feuilles de route accélèrent. Dans nos échanges avec les équipes e-commerce et CRM, l’IA est partout dans les plans 2027 : agents, conversationnel, personnalisation. Mais l’ordre compte. Sans ce socle en amont, les agents continueront à manquer d’impact, à produire des chiffres à côté de la plaque en BI et à créer du bruit pour les équipes. Les pilotes se multiplient, sans jamais passer à l’échelle.
Le constat vaut pour tous les secteurs, en B2C comme en B2B : dès qu’un agent décide, le contexte devient le nerf de la guerre.
Je suis convaincu que l’avantage concurrentiel ne viendra pas tant des modèles, accessibles à tous, que d’un cerveau industrialisé : un contexte fiable, partagé et maintenu, qui permet aux agents de prendre les bonnes décisions et aux équipes d’en garder la maîtrise.
5. Par où commencer : trois principes de terrain
Inutile de modéliser toute l’entreprise avant de lancer un premier agent. Trois principes, tirés de nos retours d’expérience, permettent d’avancer vite sans construire sur du sable.
1/ Un périmètre restreint, moins d’erreurs
Un agent qui répond juste sur un périmètre limité vaut mieux qu’un agent qui a accès à tout et se trompe. Moins de tables, des champs bien définis : il gagne en fiabilité. Commencez par une décision à fort enjeu, par exemple la prochaine action après un séjour, et le contexte strictement nécessaire pour la prendre.
2/ Corriger au plus bas niveau
Quand un agent se trompe, la tentation est d’ajouter une consigne dans son prompt. Mieux vaut corriger à la source, dans le modèle de données ou la couche sémantique. La correction profite alors à tous les usages, BI comprise, au lieu de rester un pansement propre à un agent.
3/ Construire le contexte à partir des échecs
Plutôt que de chercher à tout anticiper, enrichissez le contexte quand une question échoue, en test ou en production. Trop de contexte crée du bruit et dégrade les réponses.
Au-delà des outils, ces principes tiennent : un bon modèle de données et un contexte bien pensé servent partout.
Concrètement, une première itération ressemble à ceci :
Étape | Ce qu’on produit | Qui est impliqué |
1. Choisir la décision | Un cas d’usage, une décision, un indicateur de succès | Métier, CRM |
2. Relier les données | Les sources nécessaires, rattachées au client | Data |
3. Définir le sens | Les définitions partagées : client actif, incident, valeur… | Métiers et data |
4. Modéliser les relations | Les concepts et relations utiles à cette décision | Data et métiers |
5. Écrire les règles | Priorités, exclusions, gestes commerciaux et leur financement | Métiers, finance |
6. Brancher et tester | Accès de l’agent (via MCP par exemple), tests sur cas réels, corrections à la source | Data, IT |
6. Un chantier métier autant que data
Ce socle ne se décrète pas dans le département Data. Les définitions, les relations et les règles sont des décisions métier : qui est un client actif, ce qu’est un incident, qui finance un geste commercial. Les équipes data peuvent les outiller ; elles ne peuvent pas les arbitrer seules.
C’est là qu’un partenaire apporte de la valeur : porter la vision, aligner les métiers sur des définitions et des règles communes, et mettre en œuvre jusqu’au code, dans l’entrepôt de données comme dans les outils d’activation. C’est l’approche que nous portons chez UnNest, de la stratégie CRM à l’architecture data.
Conclusion
En 2027, la différence ne se fera pas sur l’accès aux modèles, mais sur la qualité du contexte qu’on leur donne. Les organisations qui posent dès maintenant les bases (données reliées, définitions partagées, relations explicites, règles écrites) déploieront des agents fiables. Les autres accumuleront les pilotes.
Et vous, c’est dans vos priorités pour 2027 ? Si vous voulez en parler, écrivez-moi 😉